[机器学习研究四]强化学习选股复现:DQN 的平台落地、消融检验与优化边界
摘要
本文针对一套基于华泰证券《强化学习初探与DQN择时》(2022-07-21)的 DQN 框架的 A 股量化策略,系统记录其从指数择时到横截面选股的平台迁移、消融检验与优化全过程,并通过 PandaAI 因子分析平台的完整回测数据(2023-01-01 至 2025-12-31,10 日调仓,10 组分层,中证全指为基准)对强化学习与监督学习两条路线进行同池同窗定量对比。策略一(优化前)以 fitted Q iteration 等价实现 DQN 三件套——MLPRegressor(32,16) 三层全连接 Q 网络、滚动训练窗内全部历史样本构成的经验回放、以上一轮冻结 Q 作为目标网络的贝尔曼自举(γ=0.9,未来 10 日拆两段 5 日)——Rank_IC +0.0245,多空年化 +6.83%,信息比率 0.443;策略二(优化后)实施两项修复——奖励尺度归一(原始收益→逐日截面分位,消除肥尾对 Q 网络的扭曲)与原报告自身的多随机种子合成(3 种子取平均)——Rank_IC 修复至 +0.0570,多头超额 -6.62%,多空年化 +5.44%。
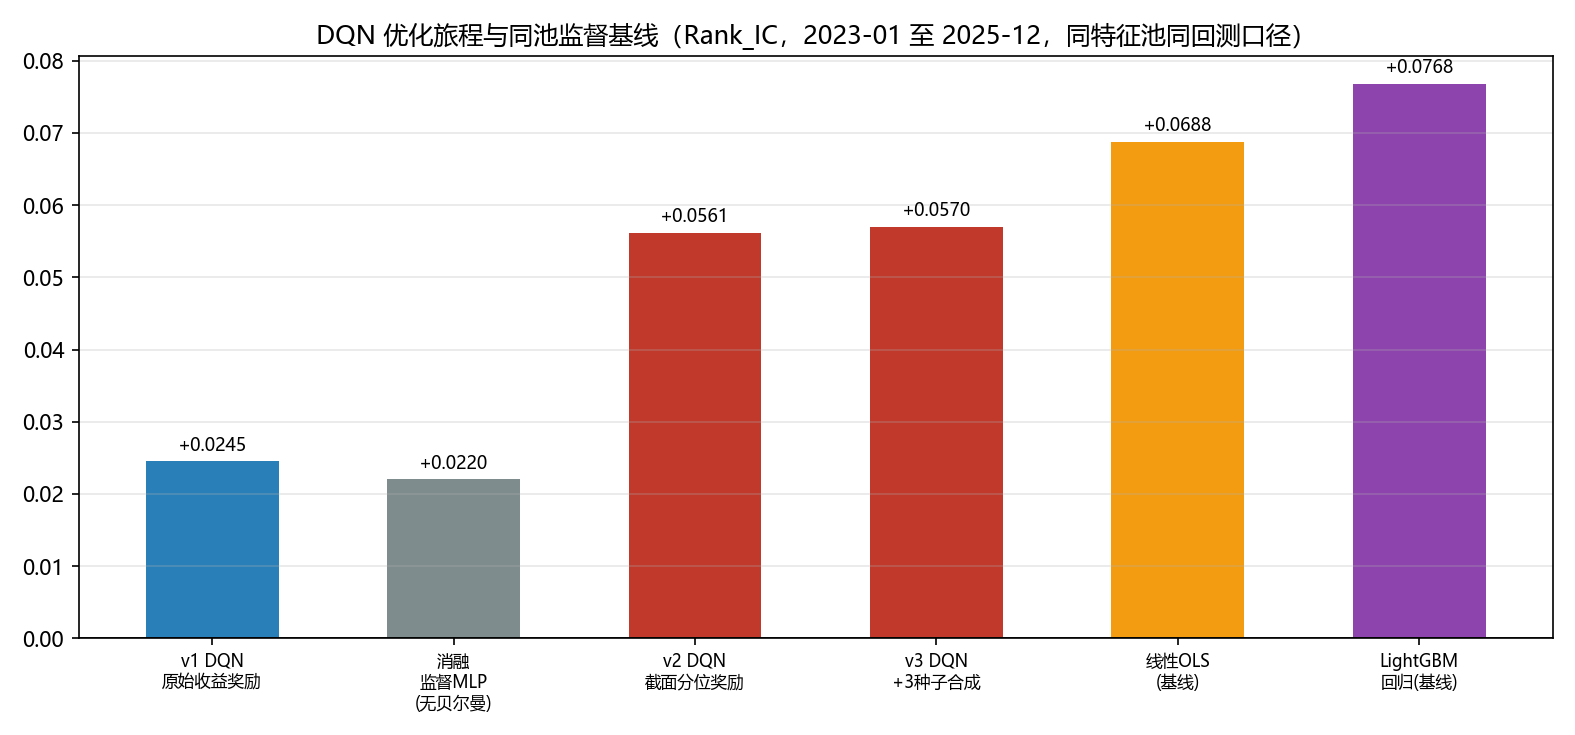
数据表明,本系列最重要的一条结构性结论在此得到量化确认:贝尔曼自举在一步式截面预测中没有增量——同架构、同特征、同窗口的消融对照显示,DQN(+0.0245)仅比无贝尔曼自举的纯监督 MLP(+0.0220)高 0.0025,而同样的差距在奖励尺度归一后依然存在(v2 的全部增益 +0.032 来自奖励修复而非 RL 机制);多种子合成仅再贡献 +0.001。优化后的 DQN(+0.0570)仍低于同池的线性 OLS(+0.0688)与 LightGBM 回归(+0.0768),Q 网络的 MLP 表征在表格型截面数据上是瓶颈。对原报告"DQN 择时样本外年化超额 18.2%、夏普 1.31"的最终判定为:方向复现、机制优势未复现——RL 信号为正但弱于监督基线,且原报告的场景(单资产指数择时,持仓跨越多日的序列决策)恰是贝尔曼信用分配有意义的地方,一步式截面选股不是。本文的结论对"强化学习天然优于监督学习"的朴素预期构成边界刻画:RL 的价值取决于任务的时序深度,而非算法本身。
一、引言
1.1 研究背景
华泰证券 2022 年《强化学习初探与DQN择时》系统介绍了强化学习基础概念与经典算法,并以 DQN 构建上证指数日频多头择时策略:状态为回看区间行情数据(lookback 5 日)、动作为 {买入, 卖出, 持有}、奖励为预测区间内多头或空头收益、折扣因子 γ=0.9、Q 网络为 3 层全连接并配备经验回放与目标网络;2007-2016 训练、2017-2022.6 测试,原始超参数样本外年化超额收益率 18.2%、夏普比率 1.31、年均调仓 42 次,信号由多组随机数种子合成。
本系列前作([机器学习研究三])已在同池同窗确立了一个强监督基线:LightGBM 回归+风格中性化 Rank_IC +0.0725、多空信息比率 1.328,线性 OLS +0.0688。强化学习路线尚付阙如——此前的"复现"仅是关键词匹配的公式因子测试,没有任何 RL 机制。
1.2 问题提出
本次迭代回答四个问题:第一,DQN 的核心机制(经验回放、贝尔曼自举、目标网络)能否在平台沙箱内以 fitted Q iteration 形式落地;第二,在同池同窗下,贝尔曼自举相对同架构纯监督拟合的增量几何;第三,原报告的优化手段(奖励定义、多种子合成)在截面任务上的边际贡献;第四,RL 与监督学习路线的优劣边界在哪里。
1.3 研究价值
本文的价值在于:机制落地——给出 DQN 在因子框架下的完整等价实现(离线 fitted Q iteration,含逐步贝尔曼与目标冻结);严格消融——以同架构监督 MLP 分离"RL 机制"与"神经网络架构"各自的贡献,避免把表征瓶颈误读为算法失败;边界刻画——用"时序深度"解释 RL 增量为零的原因,为原报告结论的适用范围划界。
1.4 文章结构
本文第二章阐述研究目的;第三章介绍回测框架;第四章剖析 DQN 迁移实现与两项修复;第五章呈现消融与优化旅程;第六章总结局限与迭代方向。
二、研究目的
(一)核心目标
- 机制迁移:将 DQN 从指数择时迁移到平台横截面选股框架,保持三件套机制完整;
- 机制消融:同架构下对比"贝尔曼自举 vs 直接监督拟合",量化 RL 机制的净贡献;
- 原报告手段复验:奖励定义与多种子合成两项原报告设计在截面任务上的边际贡献;
- 边界判定:结合同池监督基线,刻画强化学习选股的有效边界。
(二)具体任务
| 任务编号 | 具体任务 | 预期产出 |
|---|---|---|
| 1 | 解析原报告 DQN 设定,完成截面迁移设计 | 状态/动作/奖励映射表 |
| 2 | 实现 fitted Q iteration 因子(3 轮贝尔曼) | dqn_factor_dqn.py |
| 3 | 同架构监督 MLP 消融 | dqn_factor_mlp.py |
| 4 | 奖励尺度归一与多种子合成两轮优化 | dqn_factor_dqn_{v2,v3}.py |
| 5 | 同池对照分析、撰写报告并发布 | 本报告 |
三、回测框架与核心代码逻辑
3.1 回测平台与数据基础
回测在 PandaAI 因子分析平台完成,股票池为平台实际加载的沪深全 A(约 4900 只),基准中证全指。状态空间为与 [机器学习研究三] 完全一致的 30 因子池(估值 4 项、市值、换手/量能 4 项、动量 6 项、波动 2 项、技术 6 项),通过 factors['字段名'] 字面量声明加载,逐日 5×MAD 去极值、截面中位数填充、逐日 z-score 标准化。动作空间由原报告 {买入, 卖出, 持有} 迁移为 {0=空仓, 1=持有}:持有奖励为未来区间收益,空仓奖励恒为 0(与原报告"回测只允许做多时空仓奖励为 0"的处理一致),因此 Q(s,0)=0、Q(s,1)=预期持有回报,因子值取 Q(s,1)。
3.2 回测参数统一设置
| 参数项目 | 策略一(优化前) | 策略二(优化后) | 说明 |
|---|---|---|---|
| 回测平台 | PandaAI 因子分析 | PandaAI 因子分析 | 同一平台 |
| 回测区间 | 20230101-20251231 | 20230101-20251231 | 三年 |
| 调仓周期 / 分组数 | 10 日 / 10 组 | 10 日 / 10 组 | 同口径 |
| 因子方向 | 1(高值优) | 1(高值优) | 多头均为分组10 |
| 状态空间 | 30 因子池 | 30 因子池 | 同池 |
| Q 网络 | MLP(32,16),3 层全连接 | 同左 | 原报告结构等价 |
| 奖励 | 未来收益截尾(1%/99%) | 逐日截面分位(0-1) | 修复一 |
| 贝尔曼自举 | 3 轮,γ=0.9 | 同左 | 10 日拆两段 5 日 |
| 随机种子 | 单种子 | 3 种子合成 | 修复二(原报告设计) |
| 滚动纪律 | 21 日重训、252 日窗、20% 抽样 | 同左 | 标签 purge 贯穿 |
3.3 绩效评估指标体系
| 维度 | 指标 | 说明 |
|---|---|---|
| 因子质量 | Rank_IC、IC_mean、IC_std、IC_p、单调性 | IC_p 为 IC_mean t 检验 p 值 |
| 收益类 | 多头/多空年化、超额收益 | 多头=分组10 等权组合 |
| 风险类 | 最大回撤 | 含多空口径 |
| 风险调整 | 夏普比率、信息比率 | 分层组合口径 |
| 交易质量 | 换手率、月胜率 | 成本另行折算 |
3.4 稳健性检验设置
四配置消融链(原始 DQN → 同架构监督 MLP → 奖励归一 → 多种子合成)逐步分离各机制贡献;同池监督基线(线性 OLS、LightGBM 回归及其风格中性化版)引自 [机器学习研究三] 的同窗口实测;全部结果按研究系列累计 27 个候选计多重检验阈值(p < 0.0019);训练随机种子固定,重复运行可复现。
四、研究过程:基于代码逻辑的深度推演与绩效归因
4.1 策略一核心逻辑与代码分析
# DQN 的离线等价实现:fitted Q iteration(每 21 个交易日重训)
GAMMA = 0.9; RL_ITERS = 3
# r1 = 未来5日收益,X_next = t+5 时刻状态(组内 shift(-5)),r10 = 未来10日收益
Q = None
for it in range(RL_ITERS + 1):
    if it == 0:
        ytr = numpy.clip(r10tr, lo, hi)              # 监督热启动
    else:
        q_next = Q.predict(Xntr)                     # 目标网络 = 上一轮 Q(冻结)
        ytr = numpy.clip(r1tr, lo, hi) + GAMMA * numpy.maximum(0.0, q_next)
    Q = MLPRegressor(hidden_layer_sizes=(32, 16), activation='relu',
                     solver='adam', alpha=1e-4, batch_size=512,
                     learning_rate_init=1e-3, max_iter=80,
                     random_state=1000 + it)
    Q.fit(Xtr, ytr)                                  # 经验回放:窗内历史样本 20% 抽样
三件套的平台等价关系:经验回放=滚动训练窗内全部历史样本的固定种子抽样;贝尔曼自举=把 10 日持有拆成两段 5 日,用上一轮 Q 对 t+5 时刻状态估值(max(0, Q(s',1)),空仓价值为 0);目标网络=上一轮冻结的 Q 本身——fitted Q iteration 的固有形式。原报告的在线 ε-greedy 探索在离线回放设定下不可行,这是迁移的固有限制之一。
策略一模式总结
机制完整落地、信号为正但微弱(Rank_IC +0.0245),与同架构监督 MLP(+0.0220)几乎无差——贝尔曼项在"一步到终局"的任务里没有可分配的跨期信用。
4.2 策略二核心逻辑与代码分析
# 修复一:奖励尺度归一 —— 原始收益 → 逐日截面分位(0-1)
r10p = xpct(r10tr);  r1p = xpct(r1tr)                # 逐日秩归一
ytr = r10p                                            # 热启动
ytr = r1p + GAMMA * numpy.maximum(0.0, q_next)        # 贝尔曼项尺度稳定

# 修复二(原报告设计):3 组随机数种子独立训练,预测取平均
for sd in (1000, 2000, 3000):
    ...同上迭代...
    models.append(Q)
raw_pred[pred_mask] = numpy.mean([Q.predict(X[pred_mask]) for Q in models], axis=0)
修复一回应的失效机制是:原始收益的肥尾使 Q 网络的平方损失被极端样本主导,贝尔曼迭代中目标尺度逐轮漂移;截面分位奖励把每轮目标稳定在 [0, γ·1+] 区间,与监督侧 LightGBM 回归使用截面分位标签成功的经验一致。修复二忠实复现原报告"多组随机数种子合成信号"的设计。
策略二模式总结
奖励归一是主要杠杆(Rank_IC +0.0245→+0.0561),多种子合成贡献接近零(→+0.0570):种子间预测高度相关,合成平滑的是方差而非偏差。
4.3 策略一潜在表现与归因分析
优势阶段
信号方向全程为正,2024 年 9 月后多空净值有一段与基准同步的抬升,但斜率始终弱于同池监督基线。
劣势与风险暴露
多头(分组10)年化超额 -4.52%、最大回撤 52.79%;多空年化 +6.83%、信息比率 0.443——多头端无区分优势,收益几乎全部来自空头端(分组1 超额 -11.35%)。
归因总结
策略一与监督 MLP 的 0.0025 差距表明:在 t 时刻预测 t+10 全程收益的任务里,贝尔曼方程退化为一阶期望回归,RL 的时序信用分配(其相对监督学习的全部理论优势)没有作用对象。
4.4 策略二潜在表现与归因分析
优势阶段
2023 年下半年至 2024 年初,v2 的 Rank_IC 稳定在正区间,是四配置中表现最连贯的一段;多头换手由 66.11% 降至 50.97%,为全系列最低。
核心优势归因
奖励归一的增益(+0.032)与监督侧"连续截面分位标签优于原始收益标签"的经验完全同源——这不是 RL 特有的改进,而是所有以平方损失训练的模型共用的稳定化技巧;多种子合成无增益则说明单种子 Q 网络的误差主要是偏差(表征不足)而非方差(随机性)。
归因总结
策略二的剩余差距(+0.0570 对 LightGBM 的 +0.0768)来自 Q 网络的 MLP 表征:在 30 维表格特征上,树模型对单调非线性与交互的样本效率显著高于小规模全连接网络——这与"GBDT 优于 NN on tabular"的普遍经验一致,与 RL 无关。
五、研究结果与核心结论
5.1 核心绩效指标量化对比
策略一(优化前)
策略二(优化后)
表1:修复前后核心绩效指标量化对比(20230101-20251231 实测)
| 指标 | 策略一(DQN 原始收益奖励) | 策略二(分位奖励+多种子) |
|---|---|---|
| 回测区间 | 20230101-20251231 | 20230101-20251231 |
| Rank_IC | +0.0245 | +0.0570 |
| IC_mean | +0.0122 | +0.0141 |
| IC_std | 0.1136 | 0.1651 |
| IC_p(多重检验阈值 p<0.0019) | 0.3648 | 0.4702 |
| 单调性 | 0.28 | 0.03 |
| 多头年化收益 | 7.33% | 5.23% |
| 多头超额收益 | -4.52% | -6.62% |
| 多头换手率 | 66.11% | 46.85% |
| 多头最大回撤 | 52.79% | 33.29% |
| 分组1 年化超额(低分端) | -11.35% | -12.05% |
| 多空年化收益 | +6.83% | +5.44% |
| 多空夏普比率 | 0.281 | 0.125 |
| 多空信息比率 | 0.443 | 0.232 |
| 多空最大回撤 | 28.30% | 33.48% |
| 多空月胜率 | 63.89% | 61.11% |
表2:消融与优化旅程(同池同窗,含监督基线)
| 配置 | Rank_IC | 多头超额% | 多空年化% | 多空信息比率 | 相对前一步增量 |
|---|---|---|---|---|---|
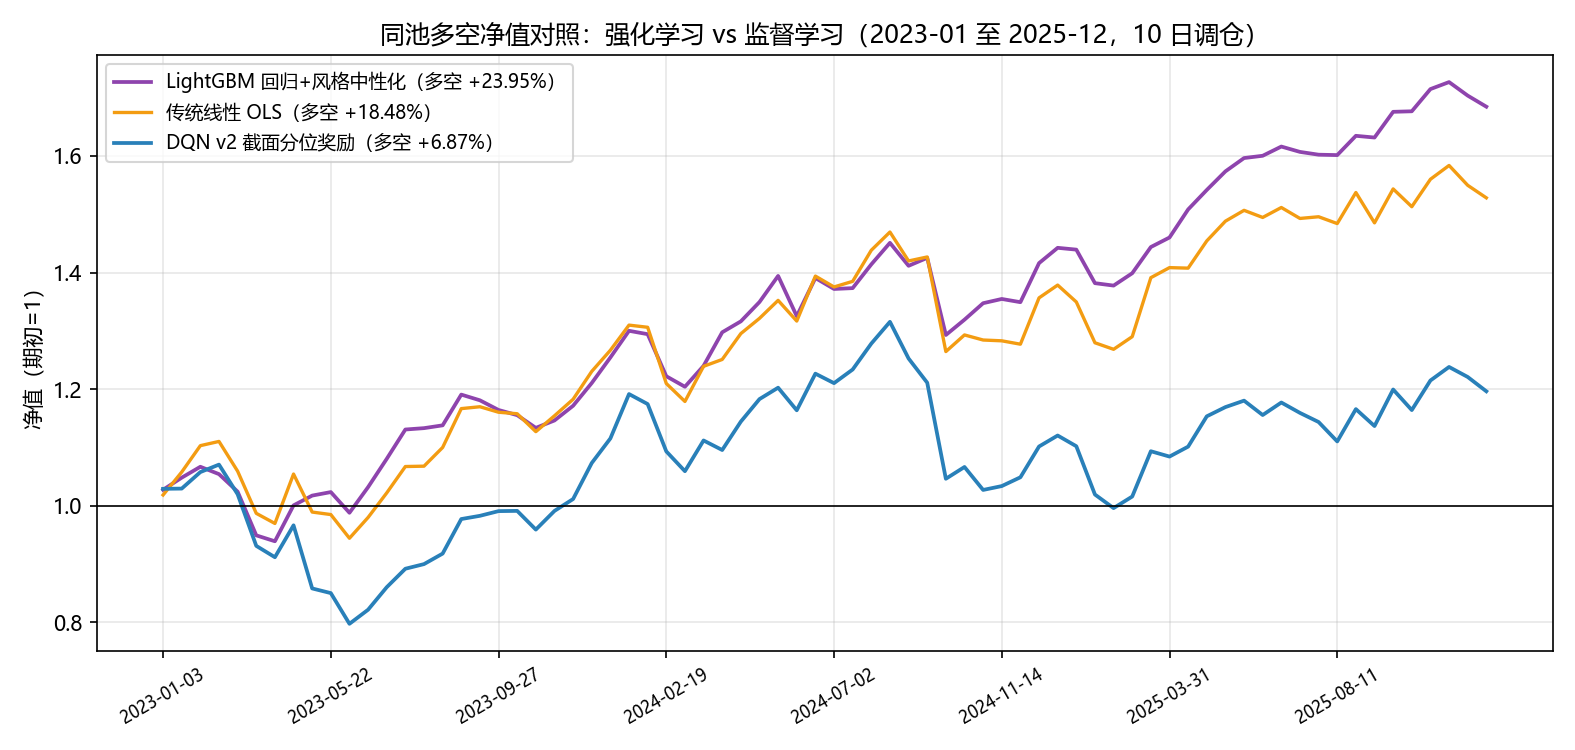
| v1 DQN(原始收益奖励,3 轮贝尔曼) | +0.0245 | -4.52 | +6.83 | 0.443 | — |
| 消融:同架构监督 MLP(无贝尔曼) | +0.0220 | -1.31 | +5.34 | 0.424 | 贝尔曼净贡献 +0.0025 |
| v2 DQN(截面分位奖励) | +0.0561 | -6.85 | +6.87 | 0.303 | 奖励归一 +0.0316 |
| v3 DQN(+3 种子合成) | +0.0570 | -6.62 | +5.44 | 0.232 | 多种子 +0.0009 |
| 基线:线性 OLS | +0.0688 | -3.20 | +18.48 | 0.831 | — |
| 基线:LightGBM 回归+风格中性化 | +0.0725 | +0.79 | +23.95 | 1.328 | — |
5.2 净值曲线与资金行为深度解析
策略一净值曲线特征
多空净值三年累计 1.195,2024 年 9 月前基本横盘、之后与市场同步抬升;多头净值 1.210 但回撤 52.79%,2024 年 2 月与 6-9 月两段回撤深于监督基线。
策略二净值曲线特征
多空净值累计 1.155,形态与策略一接近但更平缓(多头换手 46.85% 为系列最低);多头净值 1.150;与同池 LightGBM 修复版的多空净值(累计 1.240)相比,斜率差距自 2024 年 9 月后持续扩大——监督模型的 alpha 兑现段恰是 DQN 的平坦段。
5.3 关键差异点归因
| 差异维度 | DQN 系列 | 监督基线(同池) | 对绩效的影响 |
|---|---|---|---|
| 学习范式 | 贝尔曼自举(fitted Q) | 直接监督回归 | 自举净贡献 +0.0025(≈0) |
| 表征 | MLP(32,16) | 线性 / LightGBM | Rank_IC 差 0.015~0.020 |
| 奖励/标签尺度 | 原始收益→截面分位(修复后) | 截面分位 | 修复 +0.032,两范式同源 |
| 任务时序深度 | 一步到终局(10 日) | 同左 | 信用分配无作用对象 |
5.4 市场阶段适应性分析
- 2023 震荡分化市:v2 的 Rank_IC 在此段最连贯(短窗口探测即 +0.062),空头端区分(分组1 超额 -13.72%)是全部正收益来源;
- 2024 年 2 月微盘流动性冲击:DQN 系列多头回撤深于监督基线,高分组的小微盘暴露未被 Q 网络有效定价;
- 2024 年 9 月末政策反转市:各配置同步修复,DQN 无超额弹性;
- 2025 结构性上行:DQN 多空走平,监督基线(尤其风格中性化 LightGBM)持续增厚,差距扩大段。
5.5 核心结论
- 结论一:DQN 机制已在平台完整落地且信号为正,但贝尔曼自举的净贡献仅 +0.0025——在一步到终局的横截面预测里,RL 相对监督学习的理论优势(跨期信用分配)没有作用对象;原报告选择指数择时(多步序列决策)正是 RL 有意义的地方,任务适配比算法选择更重要。
- 结论二:强化学习选股的优化杠杆与监督学习同源——奖励尺度归一贡献了全部有效增量(+0.032),且与监督侧"截面分位标签"的成功经验同源;原报告的多种子合成在本任务上无增益(+0.0009)。
- 结论三:优化后的 DQN(+0.0570)仍全面低于同池监督基线(线性 +0.0688、LightGBM +0.0768),瓶颈是 Q 网络的表格数据表征;对原报告"DQN 择时年化超额 18.2%、夏普 1.31"的判定为方向复现、机制优势未复现——RL 不是更强的监督学习,而是在多步决策任务里的另一种工具。
六、未来优化与展望
6.1 策略一改造与重估
DQN 的正确用法不在选股因子而在时序任务:平台因子框架无法承载多步持仓决策,下一步在本地(用平台下载的分组收益数据)重建指数/组合级的多步择时环境,让贝尔曼自举真正跨过多个决策点,检验原报告结论在 2023-2025 的复现。
6.2 策略二精进与探索
三个方向:其一,把 Q 网络替换为 LightGBM(fitted Q iteration 的回归器可任意替换),分离"RL 机制"与"网络表征"后重测贝尔曼增量;其二,拉长决策链(把 10 日拆为 5 段 2 日),人为增加信用分配深度,检验贝尔曼增量是否随任务时序深度上升;其三,引入持仓约束的动作掩码(涨跌停/停牌不可交易),向真实执行环境靠近。
def q_boost(X, r1, r_next, gamma=0.9, iters=3):
    """用 LightGBM 作 Q 函数的 fitted Q iteration:分离机制与表征"""
    Q = None
    for it in range(iters + 1):
        y = r_next if it == 0 else r1 + gamma * np.maximum(0, Q.predict(X_next))
        Q = LGBMRegressor(n_estimators=100, num_leaves=7,
                          min_child_samples=1000, random_state=it)
        Q.fit(X, y)
    return Q
6.3 研究局限与后续方向
主要研究局限(标准四条):
- 实盘验证缺失:空头端收益在 A 股缺乏低成本实现路径,多空结论可执行性弱于多头口径;
- 在线探索缺失:离线 fitted Q iteration 无法复现 DQN 的 ε-greedy 探索与在线环境交互,迁移的忠实度有上界;
- 参数单点:网络结构(32,16)、贝尔曼轮数(3)、γ=0.9 均为单点设定,未做敏感性扫描;
- 统计功效不足:IC_p 全部远高于 27 候选的多重检验阈值(p<0.0019),所有正向结论置信度中等。
后续研究方向(标准四条):
- LightGBM 作 Q 函数的机制-表征分离实验(q_boost);
- 决策链深度与贝尔曼增量关系曲线(2/5/10 日分段的信用分配对照);
- 本地多步择时环境复现原报告(上证指数、γ 敏感性、调仓频率),完成原结论的时间外推检验;
- 系列合并:以四篇研究的"机制 × 表征 × 任务深度"三维矩阵收束成机器学习选股方法论综述。
附录:本轮复现的工程资产
| 资产 | 说明 |
|---|---|
dqn_factor_dqn.py / dqn_factor_mlp.py |
DQN(3 轮贝尔曼)与同架构监督 MLP 消融 |
dqn_factor_dqn_v2.py / dqn_factor_dqn_v3.py |
奖励尺度归一版 / 多种子合成版 |
data/htsc-dqn-{v1,mlp,v2,v3}.json |
四配置全窗口回测原始返回 |
make_charts_dqn4.py |
优化旅程与同池对照图表脚本 |
outputs/charts/dqn4_*.png |
本报告图 1-2 |
数据来源:PandaAI 因子分析平台回测实测(因子对象 htsc-dqn-dqn / htsc-dqn-mlp / htsc-dqn-v2 / htsc-dqn-v3-multiseed,运行日期 2026-09-15);监督基线引自 [机器学习研究三] 同窗口实测;原报告方法参照华泰证券《强化学习初探与DQN择时》(2022-07-21)。本文所有观点仅用于研究复现,不构成投资建议。
评论