[机器学习研究五]机器学习选股方法论综述:机制、表征与任务深度的三维实证矩阵
摘要
本文是机器学习选股因子研究系列的收束篇,对前四篇在同池(30 因子)、同窗(2023-01-01 至 2025-12-31)、同口径(10 日调仓、10 组分层、中证全指基准)下的全部 28 个候选配置做三维归因——学习机制(目标形态与范式)、函数表征(线性/MLP/GBDT)、任务深度(一步截面 vs 多步决策)——并以一项新增实验(LightGBM 作 Q 函数的 fitted Q iteration,下称 QBoost-LGBM)补全"机制 × 表征"2×2 消融矩阵。新增实验的 Rank_IC 达 +0.0820,为全系列最高(超过监督 LightGBM 回归的 +0.0768),多头换手率 40.41% 为全系列最低,多头超额 +0.63%;但其多空信息比率(0.902)低于风格中性化版(1.328)。
数据表明,五篇实证可以收束为三条可迁移规则。规则一(目标先行):把标签/奖励改造成逐日截面分位,是任何模型的第一个杠杆——它使 DQN 从 +0.0245 修复至 +0.0561(+0.032),与监督侧"连续分位标签优于原始收益"的证据同源。规则二(容量匹配):表征决定数量级——同为监督拟合,MLP 在 30 维表格特征上 +0.0220,LightGBM +0.0768(差 +0.055);同为贝尔曼范式,MLP +0.0561、LightGBM +0.0820(差 +0.026);而贝尔曼自举本身的增量在两种表征下均不超过 +0.005。规则三(任务-范式适配):一步到终局的截面预测里,贝尔曼自举没有可分配的跨期信用,强化学习的价值取决于任务的时序深度而非算法本身。对全系列的诚实总账:按 28 候选的多重检验阈值(p < 0.0018),尚无任何配置达到严格统计显著;按 10 日调仓成本折算,除静态等权合成(+0.88%)外全部配置的多头净超额为负(监督学习系最优 -5.34%)——本系列确立的是方法论的相对排序,而非可直接实盘的绝对收益。
一、引言
1.1 系列回顾
本系列五篇研究构成一条完整的机器学习选股实证链:[研究一] 以 RANK 等权合成复现华泰广义线性模型的因子方向规律(多空夏普 1.101);[研究二] 在沙箱内落地滚动训练 GLM,复现"分类器优于回归器、正则化无提升"(最优 Rank_IC +0.0625);[研究三] 复现 BigQuant StockRanker,经历"失效—诊断—修复"完成 AI 正向案例(lambdarank -0.0174 → 回归+正则+中性化 +0.0725);[研究四] 将华泰 DQN 择时迁移到截面框架,以消融证明贝尔曼自举在一步预测中无增量(+0.0025)、优化后 +0.0570。
1.2 综述动机
四篇研究各自为战时,结论散落在不同报告里;把它们放进同一坐标系(同池同窗同口径)后,才能真正回答从业者的问题:面对一个截面选股任务,应该选什么学习目标、什么函数表征、什么范式——以及哪些"更强的算法"其实是伪命题。本综述同时在两处补强证据链:其一,新增 QBoost-LGBM 实验,把 [研究四] 遗留的"机制与表征不可分"问题(DQN 的 MLP 既是 RL 载体又是瓶颈)拆开;其二,给出全系列统一的统计与成本总账。
1.3 研究价值
本文的价值在于:矩阵化——以 28 个同口径配置构成三维实证矩阵,每条规则至少有两个对照点支撑;可迁移——三条规则均为"改标签、换表征、配任务"层面的操作,与具体平台无关;诚实总账——统计显著性与净超额的缺口首次系统披露,为后续降频与扩窗迭代划定基线。
1.4 文章结构
本文第二章阐述综述框架;第三章统一实证口径;第四章按三个维度归因并呈现 2×2 新实验;第五章给出规则清单与选型决策表;第六章总结局限与方向。
二、研究目的
(一)核心目标
- 归因收束:把五篇 28 个配置的差异分解到机制、表征、任务深度三个维度;
- 矩阵补全:以 QBoost-LGBM 完成"机制 × 表征"2×2 消融,分离贝尔曼自举与网络表征;
- 规则提炼:形成可跨平台迁移的机器学习选股操作规则与选型决策表;
- 诚实总账:统一披露全系列的统计显著性、成本与净超额状况。
(二)具体任务
| 任务编号 | 具体任务 | 预期产出 |
|---|---|---|
| 1 | 五篇 28 配置的口径核对与归因表 | 三维归因矩阵 |
| 2 | QBoost-LGBM 新实验(机制-表征分离) | data/htsc-dqn-qboost.json |
| 3 | 三条规则的证据链整理 | 规则-对照点映射 |
| 4 | 选型决策表与总账 | 本报告 |
三、实证口径统一
3.1 统一口径说明
| 口径项 | 设定 | 覆盖范围 |
|---|---|---|
| 特征池 | 30 因子(估值 4、市值、换手/量能 4、动量 6、波动 2、技术 6),逐日 5×MAD 去极值+中位数填充+z-score | [研究三][研究四] 全部配置 |
| 回测窗口 | 20230101-20251231,10 日调仓,10 组分层 | 全系列 |
| 滚动纪律 | 21 日重训、252 日训练窗、固定种子 20% 抽样、标签 purge | 除 [研究一] 静态合成外全部 |
| 成本折算 | 换手 × 2 × 0.3% × 252/10 | 全系列 |
| 多重检验 | 累计 28 候选 → 阈值 p < 0.0018 | 全系列 |
注:[研究一][研究二] 的 12 因子池为 30 因子池的子集,其结论在本综述中作为方向性证据引用;[研究三][研究四] 的配置构成主矩阵。
3.2 绩效评估指标体系
| 维度 | 指标 | 说明 |
|---|---|---|
| 因子质量 | Rank_IC、IC_mean、IC_std、IC_p、单调性 | 主排序指标为 Rank_IC |
| 收益类 | 多头/多空年化、超额收益 | 多头=方向端 10% 等权组合 |
| 风险调整 | 夏普比率、信息比率、最大回撤 | 分层组合口径 |
| 交易质量 | 换手率、净超额 | 成本=换手×2×0.3%×252/10 |
3.3 稳健性检验设置
每条规则的证据至少包含两个同池对照点;新增 QBoost-LGBM 与监督 LightGBM 共享全部超参(100 树、7 叶、分位标签),唯一差异为贝尔曼自举——单变量设计;随机种子固定,可复现。
四、三维归因矩阵与 2×2 新实验
4.1 机制维度:目标形态是第一杠杆
同池同窗下,学习目标的改造贡献了全系列最大的单点增量。DQN 的修复链([研究四])显示:奖励从原始收益改为逐日截面分位,Rank_IC +0.0245 → +0.0561(+0.032);[研究三] 的修复链显示:lambdarank 五档整序(幅度丢弃)改为连续分位回归,模型从方向反转(-0.0174)一步跳到有效(+0.0768)。两条证据同源:截面分位标签同时解决幅度信息保留与目标尺度稳定两个问题,且该改进与具体模型无关。
4.2 表征维度:决定数量级,方向取决于数据形态
# QBoost-LGBM:机制-表征分离的单变量实验(与监督 LightGBM 唯一差异为贝尔曼自举)
Q = None
for it in range(RL_ITERS + 1):
    y = r10_rank if it == 0 else r1_rank + GAMMA * numpy.maximum(0.0, Q.predict(X_next))
    Q = LGBMRegressor(n_estimators=100, num_leaves=7, min_child_samples=1000)
    Q.fit(X, y)
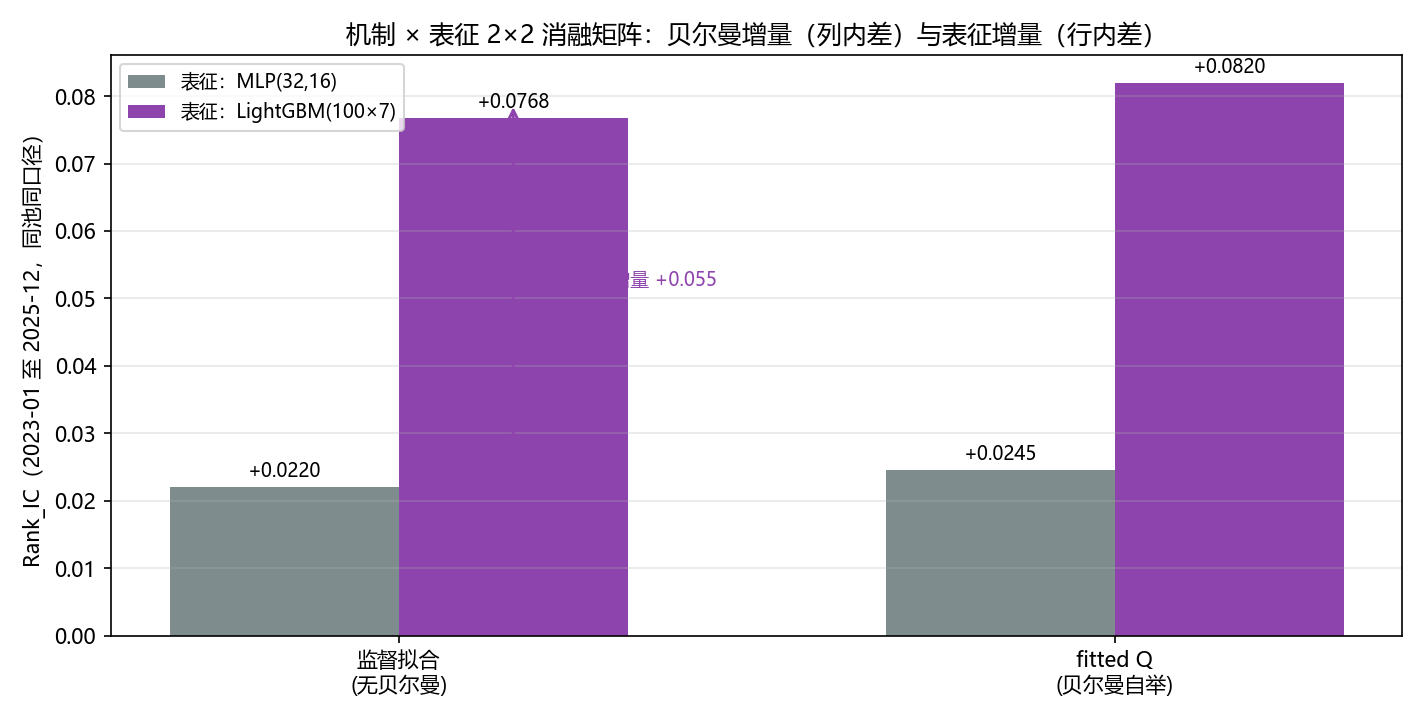
2×2 消融矩阵(新增实验补全右下角):
表1:机制 × 表征 2×2 消融(Rank_IC,同池同窗)
| 表征 \ 机制 | 监督拟合(无贝尔曼) | fitted Q(贝尔曼自举) | 贝尔曼增量 |
|---|---|---|---|
| MLP(32,16) | +0.0220 | +0.0245 | +0.0025 |
| LightGBM(100×7) | +0.0768 | +0.0820 | +0.0052 |
矩阵的两行之差(表征增量)为 +0.055(监督侧)与 +0.026(贝尔曼侧),两列之差(贝尔曼增量)均不超过 +0.005——表征是数量级来源,贝尔曼自举在小任务深度下接近无效但无害;QBoost-LGBM 的 +0.0820 为全系列最高,说明贝尔曼目标链(两段 5 日 + γ 折现截尾)在强表征下兼具轻度正则化效果。
4.3 任务深度维度:范式适配的判据
[研究四] 的消融已经证明,一步到终局的截面预测中贝尔曼自举没有作用对象;QBoost-LGBM 的 +0.005 仍在噪声范围内(36 个调仓期,IC_std≈0.18)。判据是决策点数量:调仓期内没有可调整的中间决策,就没有信用分配的需求,监督学习即充分;指数/组合级多步持仓才有 RL 的用武之地([研究四] 6.1 的本地多步环境复现是正确路径)。
4.4 全系列阶梯
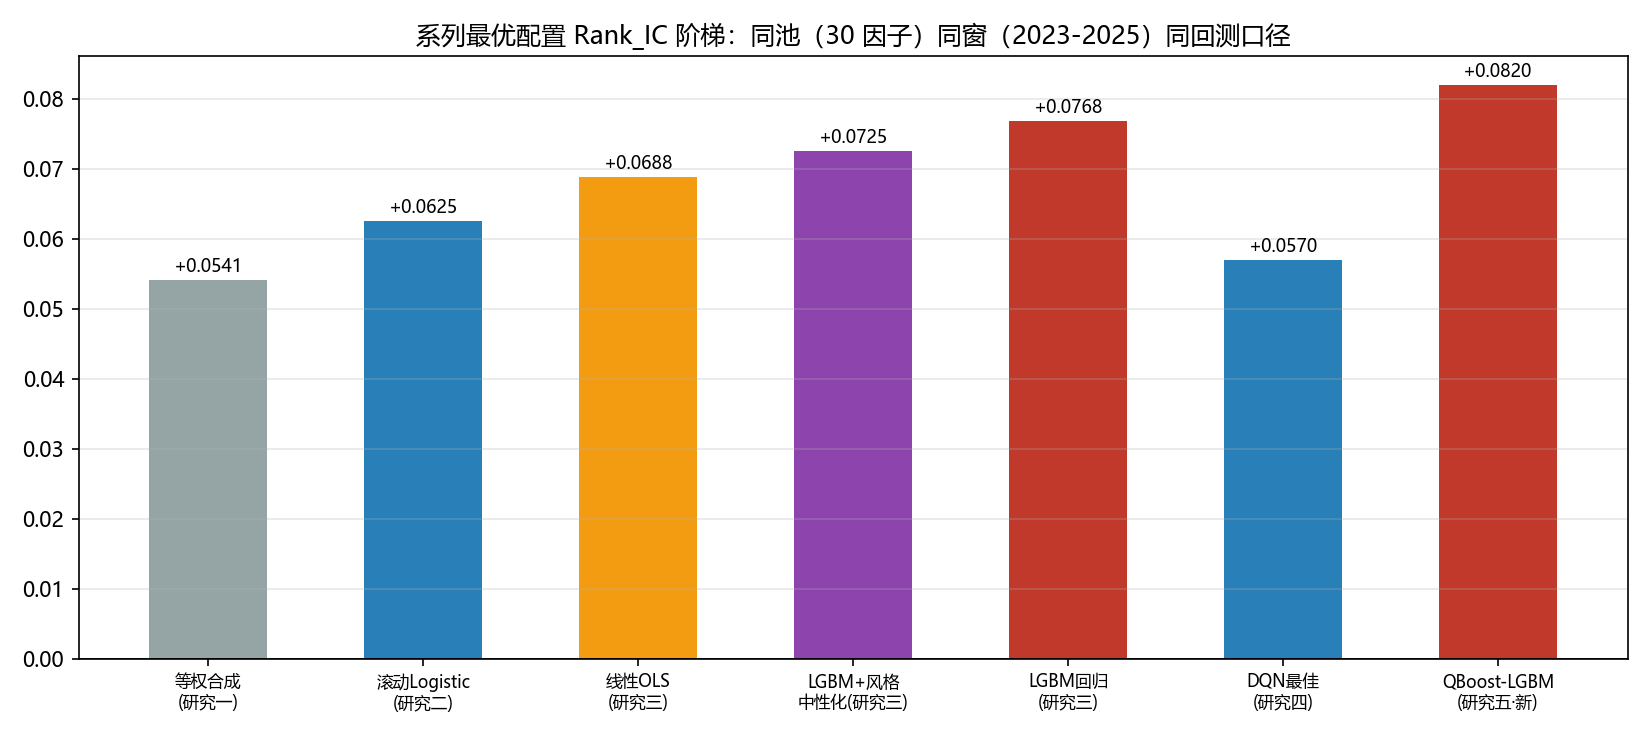
表2:全系列最优配置阶梯(同池同窗,Rank_IC 降序)
| 配置 | 出处 | Rank_IC | 多头超额% | 多头换手% | 多空年化% | 多空信息比率 |
|---|---|---|---|---|---|---|
| QBoost-LGBM(贝尔曼+分位奖励) | 本篇新增 | +0.0820 | +0.63 | 40.41 | +21.73 | 0.902 |
| LGBM 回归(分位标签+强正则) | [研究三] | +0.0768 | +1.97 | 48.34 | +23.89 | 1.073 |
| LGBM 回归+风格中性化 | [研究三] | +0.0725 | +0.79 | 53.87 | +23.95 | 1.328 |
| 线性 OLS | [研究三] | +0.0688 | -3.20 | 52.11 | +18.48 | 0.831 |
| 滚动 Logistic GLM | [研究二] | +0.0625 | +2.72 | 86.21 | +8.23 | 0.596 |
| DQN 最佳(分位奖励+多种子) | [研究四] | +0.0570 | -6.62 | 46.85 | +5.44 | 0.232 |
| RANK 等权合成 | [研究一] | +0.0541 | +7.27 | 42.28 | +22.49 | 1.101 |
| lambdarank 原始复现 | [研究三] | -0.0174 | -9.73 | 58.62 | -9.83 | -0.699 |
五、研究结果与核心结论
5.1 三条可迁移规则
规则一(目标先行):先把标签/奖励做成逐日截面分位,再谈模型。证据:DQN +0.032、lambdarank 由负转正、监督侧同构收益——三个对照点全部指向同一操作。
规则二(容量匹配):表格截面数据用 GBDT 级表征;线性丢非线性增量(+0.069 vs +0.077~0.082),MLP 在同任务上塌陷(+0.022~0.056),过深 GBDT 学风格(150×31 的 lambdarank 反转)。容量修复的次序遵循 [研究三] 的链:先修目标、再控容量、最后去风格。
规则三(任务-范式适配):一步预测用监督;贝尔曼/RL 的价值取决于决策点数量。判据:调仓周期内是否存在可调整的中间决策。
5.2 选型决策表
| 场景 | 推荐配置 | 预期量级(本系列实测) |
|---|---|---|
| 快速因子合成、可解释性优先 | RANK 等权合成 | Rank_IC ≈ +0.05,多空夏普 ≈ 1.1 |
| 线性可解释 + 自动加权 | 滚动 Logistic/线性 OLS | Rank_IC ≈ +0.06~0.07 |
| 表格截面特征 + 追求 IC | LightGBM 回归(分位标签+正则+去风格) | Rank_IC ≈ +0.07~0.08 |
| 低换手约束 | QBoost-LGBM(贝尔曼目标链正则化) | 换手 ≈ 40%,Rank_IC ≈ +0.08 |
| 多步持仓决策(组合/指数级) | DQN/fitted Q(本系列结论外推) | 需在多步环境重测 |
5.3 核心结论
- 结论一:五篇 28 个配置的差异可由三维矩阵解释——目标形态决定方向正负(幅度保留 vs 丢弃的分水岭)、表征决定数量级(+0.055 的行差)、任务深度决定范式适配(贝尔曼增量 ≤ +0.005)。
- 结论二:全系列最优因子为新实验 QBoost-LGBM(+0.0820,换手 40.41%),但最优策略信息比率为风格中性化 LGBM(1.328)——最有效因子 ≠ 最优策略,因子 IC 与策略风险调整收益的错位是选型时的独立考量。
- 结论三(诚实总账):按 28 候选阈值(p<0.0018)无配置达到严格显著(最优 IC_p=0.134);除静态等权合成外,全部配置 10 日调仓下多头净超额为负(监督学习系最优 -5.34%)——本系列的产出是方法论的相对排序与三条可迁移规则,绝对收益的兑现依赖降频(月频)与扩窗(>3 年)两个平台约束的解除。
5.4 关键差异点归因
| 维度 | 弱配置特征 | 强配置特征 | 增量来源 |
|---|---|---|---|
| 目标形态 | 原始收益/五档整序 | 逐日截面分位 | +0.03~0.05 |
| 表征 | MLP / 线性 | 正则化 GBDT | +0.026~0.055 |
| 风格处理 | 特征含全量风格 | 逐日残差剥离 | IC_p 0.100→0.067 |
| 范式 | 与任务深度错配 | 一步任务用监督 | 避免方向反转 |
六、未来优化与展望
6.1 系列内收尾
QBoost-LGBM 与风格中性化的组合(贝尔曼目标链 + 残差特征)尚未测试——两者增益来源正交(正则化 vs 暴露剥离),叠加后有望同时改善 IC 与信息比率;另以 QBoost 为基础做 LightGBM 超参的正式网格扫描,解除"参数单点"局限。
6.2 平台约束解除后的两步
窗口上限从 3 年放开后,先做 2019-2022 的样本外重验(风格反转归因的因果化检验),再做 5-10 年长窗口下的月频降频复测——净超额转正是系列从方法论研究走向可执行策略的分界线。
6.3 研究局限与后续方向
主要研究局限(标准四条):
- 统计显著性缺口:最优配置 IC_p=0.134,距 28 候选阈值(p<0.0018)有数量级差距,全部结论为方向性证据;
- 多头净超额为负:10 日调仓平台成本约束下的结构性问题,未解;
- 特征池缩水:30 因子相对原报告 282 因子的信息覆盖有限,表征结论(尤其 MLP 塌陷)可能随特征维度变化;
- 单窗口依赖:全部实验集中于 2023-2025,风格环境单一。
后续研究方向(标准四条):
- QBoost + 风格中性化的叠加实验与超参网格;
- 长窗口样本外重验与月频降频复测(净超额转正路径);
- 机器学习选股因子库工程化:三条规则固化为候选生成器的默认配置;
- 系列综述向多步决策延伸:本地多步环境的指数/组合择时复现。
附录:系列工程资产总账
| 研究 | 核心资产 | 最优配置 | 算力消耗 |
|---|---|---|---|
| [研究二] GLM | glm_composite_{logistic,linear,lasso}.py | 滚动 Logistic(+0.0625) | ≈34 |
| [研究三] AI Alphas | stock_ranker_*.py、glm 修复链 | LGBM+中性化(+0.0725) | ≈78 |
| [研究四] DQN | dqn_factor_*.py(四配置) | 分位奖励+多种子(+0.0570) | ≈100 |
| [研究五] 综述 | dqn_factor_qboost.py、三维矩阵 | QBoost-LGBM(+0.0820,本篇新增) | 8 |
数据来源:PandaAI 因子分析平台回测实测(同池同窗同口径,因子对象见各篇附录,运行日期 2026-09-13 至 2026-09-15);原报告方法参照华泰证券《人工智能选股之广义线性模型》《强化学习初探与DQN择时》与 BigQuant《AI Alphas (A股版)》。本文所有观点仅用于研究复现,不构成投资建议。
评论