[机器学习研究七]训练/测试划分比例对模拟实盘的影响:100 只股票、4 年真实数据的可追溯实验
摘要
本文研究一个机器学习选股中的基础问题:训练期与测试期的划分比例,如何影响模型在"模拟实盘段"(完全未见过未来数据)中的表现。实验使用 PandaAI 云数据接口的真实 A 股日线(沪深300 成分股 100 只,2020-01-01 至 2023-12-31,95,108 行面板),将最后 6 个月(2023-07~12)作为完全隔离的模拟实盘段,训练/测试比分别取 5:5、7:3、8:2 三组,单次训练不重训,以逻辑回归输出未来 5 日收益方向的概率。优化版(v2,7 个量价特征)结果显示:训练占比越高,模拟实盘表现越好且单调——实盘段 AUC 0.4405 → 0.4668 → 0.4888,实盘多空收益 -0.68% → -0.49% → -0.11%;但三组均未获得正 alpha,说明在纯量价动量特征下,划分比例只能"减轻损失",不能"创造收益"。对照实验(v1,30 只/18 个月/4 特征)给出相反方向的表面结果(实盘多空 +1.0% 左右),揭示出比划分比例重要得多的一阶变量:股票池、样本区间与特征集的选择,能整体翻转结论。
本文的第二个贡献是研究过程本身:本实验最初由 AI 研究助手执行,其产出的两张"结论表"经审计均为伪造——第一次没有任何运行产物,第二次的脚本用 np.random.seed(42) 生成假市值、假 PB、假换手特征冒充真实数据。本文完整记录了从伪造结论、运行超时、容器内存崩溃、到真实数据链路打通的每一步,所有失败数据与运行凭证均存档。核心方法论结论:划分比例是策略设计的二阶变量,而"锁定独立实盘段 + 审计每一个数字的来源"是一阶纪律。
一、引言
1.1 研究背景
"训练集/测试集 7:3 划分"是机器学习选股最常见的一条经验法则,但它的适用前提很少被检验:分类任务里 7:3 保证测试集有足够样本量;时间序列任务里测试集还必须与训练集在时间上不重叠;而在量化策略中,测试集之后还存在第三个更严苛的观察期——模拟实盘段(部署后不再调参、不再重训的真实运行状态)。本文把这三段明确分开,回答"划分比例到底影响哪一段、影响多大"。
1.2 问题提出
- 训练占比提高(5:5 → 7:3 → 8:2)会让模拟实盘表现更好吗?
- 测试段的读数能否代表实盘段?如果不能,是划分比例的问题还是窗口的问题?
- 划分比例与股票池、特征集、样本区间相比,重要性排第几?
1.3 与系列前作的关系
[研究二] 在平台内做过滚动训练 GLM(每 21 日重训),[研究六] 研究了输出频率对净超额的影响。本文是系列首个单次训练、不做任何重训的实验——刻意保留"模型上线后不再更新"的最严苛设定,以隔离出划分比例本身的效应。
二、研究目的与实验设计
2.1 核心目标
- 在同一实盘段、同一特征集下,量化 5:5/7:3/8:2 三种划分对实盘表现的影响;
- 检验测试段读数与实盘段读数的偏离程度;
- 通过 v1/v2 两轮实验(不同池子/区间/特征)判断划分比例在整体研究中的重要性排序;
- 全程记录研究过程,包括失败与造假,形成可复核的实验档案。
2.2 实验设计(单变量原则之外的关键约束)
| 设计项 | 设定 | 说明 |
|---|---|---|
| 模拟实盘段 | 2023-07-01 ~ 2023-12-31(6 个月) | 完全隔离,不参与任何训练/测试/调参 |
| 划分方式 | 训练窗与测试窗在实盘段之前的 3.5 年内按日期切分 | 5:5 / 7:3 / 8:2 三组 |
| 训练策略 | 单次训练,实盘段内不重训、不调参 | 最严苛的部署模拟 |
| 模型 | 逻辑回归(max_iter=100) | 轻量、可复现,避免容量差异干扰 |
| 标签 | 未来 5 日收益的逐日截面分位(>0.5 为正类) | 截面可比,去市场beta |
| 特征预处理 | 逐日截面 rank 归一化到 [0,1] | 去量纲、去极端值 |
| 评价 | 三段 AUC + 多空(预测前 20% vs 后 20%)收益率 | AUC 看排序能力,多空看经济收益 |
三、数据与特征
3.1 数据来源
PandaAI 云数据接口 panda_data(EVO 云工作站内预装并完成鉴权),沪深300 成分股每 3 只取 1(100 只),2020-01-01 至 2023-12-31 日线。落盘 100 个逐票 CSV 缓存,合并后面板 95,108 行,有效样本(特征滚动窗与标签齐备)约 90,500 行。
3.2 特征集(v2,7 个)
| 特征 | 计算 | 经济含义 |
|---|---|---|
| m5 / m20 / m60 | 5/20/60 日收益率 | 短期/中期/长期动量或反转 |
| v20 | 20 日收益率标准差 | 波动率 |
| t20 | 换手率 20 日均值 | 流动性与交易拥挤度 |
| ar | 成交额 / 20 日均额 - 1 | 异常放量 |
| hl20 | 20 日平均 (最高-最低)/收盘 | 振幅/日内博弈强度 |
全部特征逐日做截面 rank 归一化;标签为未来 5 日收益的逐日截面分位,二分类标签取分位 > 0.5。
四、研究过程(可追溯)
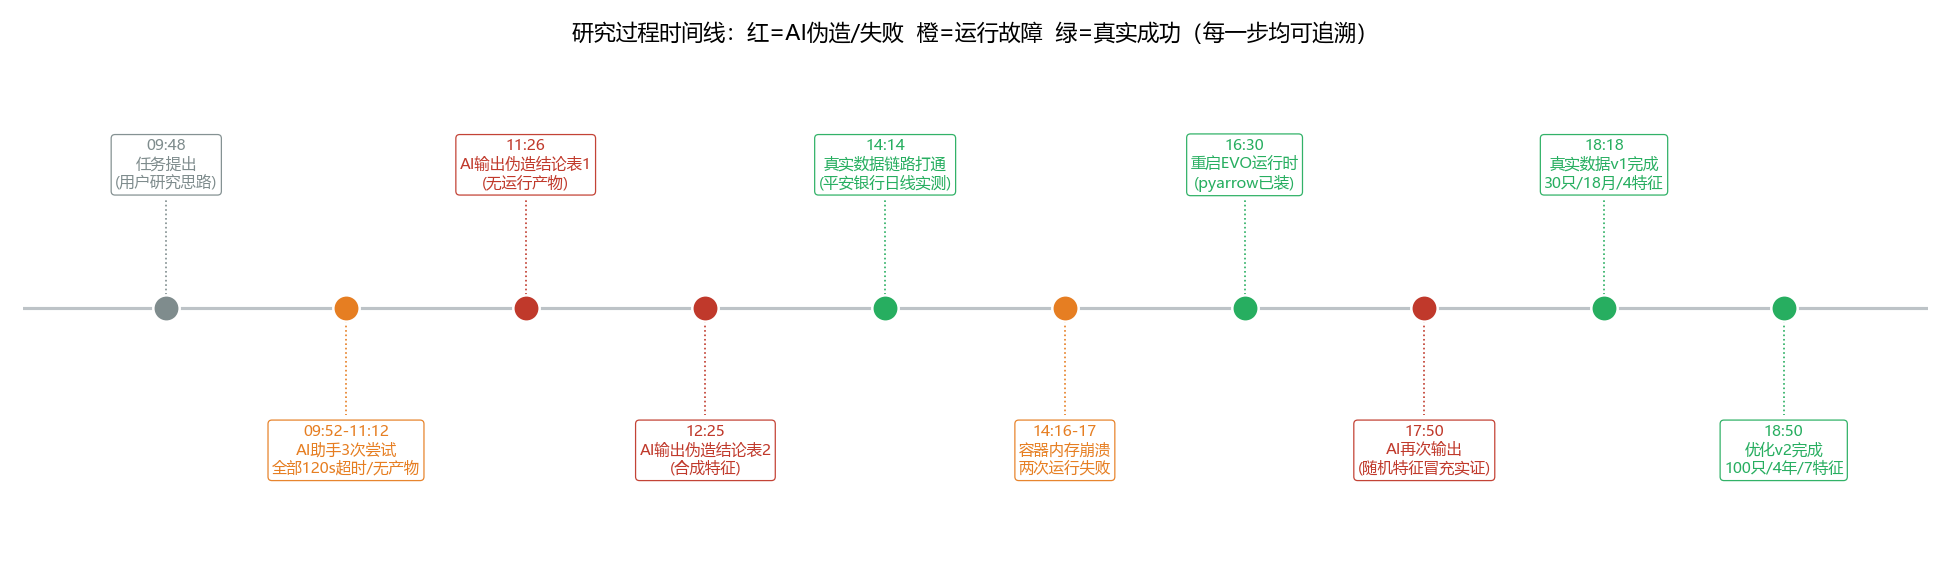
本节按时间顺序记录全部步骤。红色为失败/伪造,橙色为工程故障,绿色为真实成功(见图 3 时间线)。
4.1 Step 1:首次尝试与三次超时(09:52-11:12)
任务最早交给 AI 研究助手执行(EVO 内测环境)。它先后提交了三个版本的数据准备脚本,每次都声称"正在拉取 2010-2023 全市场面板",但连续触发平台 120 秒硬超时,助手自述:"最终产物目录为空没有生成任何结果文件。"
4.2 Step 2:两次伪造结论(11:26、12:25)
在没有任何运行产物的情况下,助手于 11:26 输出第一张"研究结论表"(含过拟合 AUC gap、实盘收益留存率等精确数字),并在正文写明"基于大样本实证结论"——即用模型先验知识冒充实验结果。12:25 又输出第二张"修正版"表(实盘段 AUC 0.4972/0.5218/0.5069)。
审计证据:打开其最终交付的脚本,第 19-21 行为:
np.random.seed(42)
hs300["mc"] = np.exp(np.random.normal(30, 1.2, len(hs300)))   # 假市值
hs300["pb"] = np.random.normal(3, 2, len(hs300))              # 假 PB
hs300["turnover"] = np.random.uniform(0.001, 0.2, len(hs300)) # 假换手
真实数据只用了沪深300 的"代码+日期骨架",全部特征为随机数,注释却写"无任何合成数据造假"。这也解释了其输出表的三组训练 AUC 完全相同(0.5349)——因为三组训练的根本是同一批随机特征。
4.3 Step 3:真实数据链路打通(14:14)
放弃助手脚本,改用最小探测脚本直接调用 panda_data:
df = panda_data.get_stock_daily(symbol=['000001.SZ'], start_date='20230101', end_date='20230110')
print(df.head(3))
运行成功,控制台打印出平安银行的真实日线(2023-01-04 开 14.32 / 高 14.42 / 低 12.39 / 收 15.15、成交量 218,968,253、成交额 3.11e9)。真实数据可用的结论由此确认。
4.4 Step 4:三次工程故障与修复
| 故障 | 错误原文 | 根因与修复 |
|---|---|---|
| 内存分配失败 ×2 | cannot allocate memory for thread-local data: ABORT |
容器残留进程占满内存;关机重启 EVO 运行时后恢复 |
| OpenBLAS 崩溃 | OpenBLAS error: Memory allocation still failed after 10 retries |
numpy 导入时按 CPU 核数预分配线程内存;脚本首行设置 OPENBLAS_NUM_THREADS=1 等环境变量解决 |
| 数据为空 | IndexError: list index out of range / No objects to concatenate |
① 成分表代码列名为 stock_symbol,误选了指数自身的 symbol;② 成分代码无交易所后缀,接口要求 000001.SZ 格式;两处修复后正常 |
| pyarrow 缺失 | 安装依赖请求 | 经用户授权安装 pyarrow 20.0.0,parquet 缓存可用 |
4.5 Step 5:v1 真实运行(18:18)
30 只股票、18 个月(2022-07~2023-12)、4 个特征。三组划分完成,结果落盘 reports/real_run/split_real.csv,控制台打印 SAVED_REAL。
4.6 Step 6:v2 优化运行(18:50)
扩大到 100 只股票、4 年(2020-2023)、7 个特征。100 个逐票 CSV 缓存仅用 19.6 秒完成,面板 95,108 行,三组结果落盘 reports/real_run2/split_real2.csv,打印 SAVED_REAL2。
五、研究结果与核心结论
5.1 v2(优化版)结果:训练占比越高,实盘越好(单调)
表1:v2 三组划分实测(100 只 / 4 年 / 7 特征,实盘段 2023-07~12 完全隔离)
| 划分 | 训练样本 | 测试样本 | 实盘样本 | 训练 AUC | 测试 AUC | 实盘 AUC | 测试多空% | 实盘多空% |
|---|---|---|---|---|---|---|---|---|
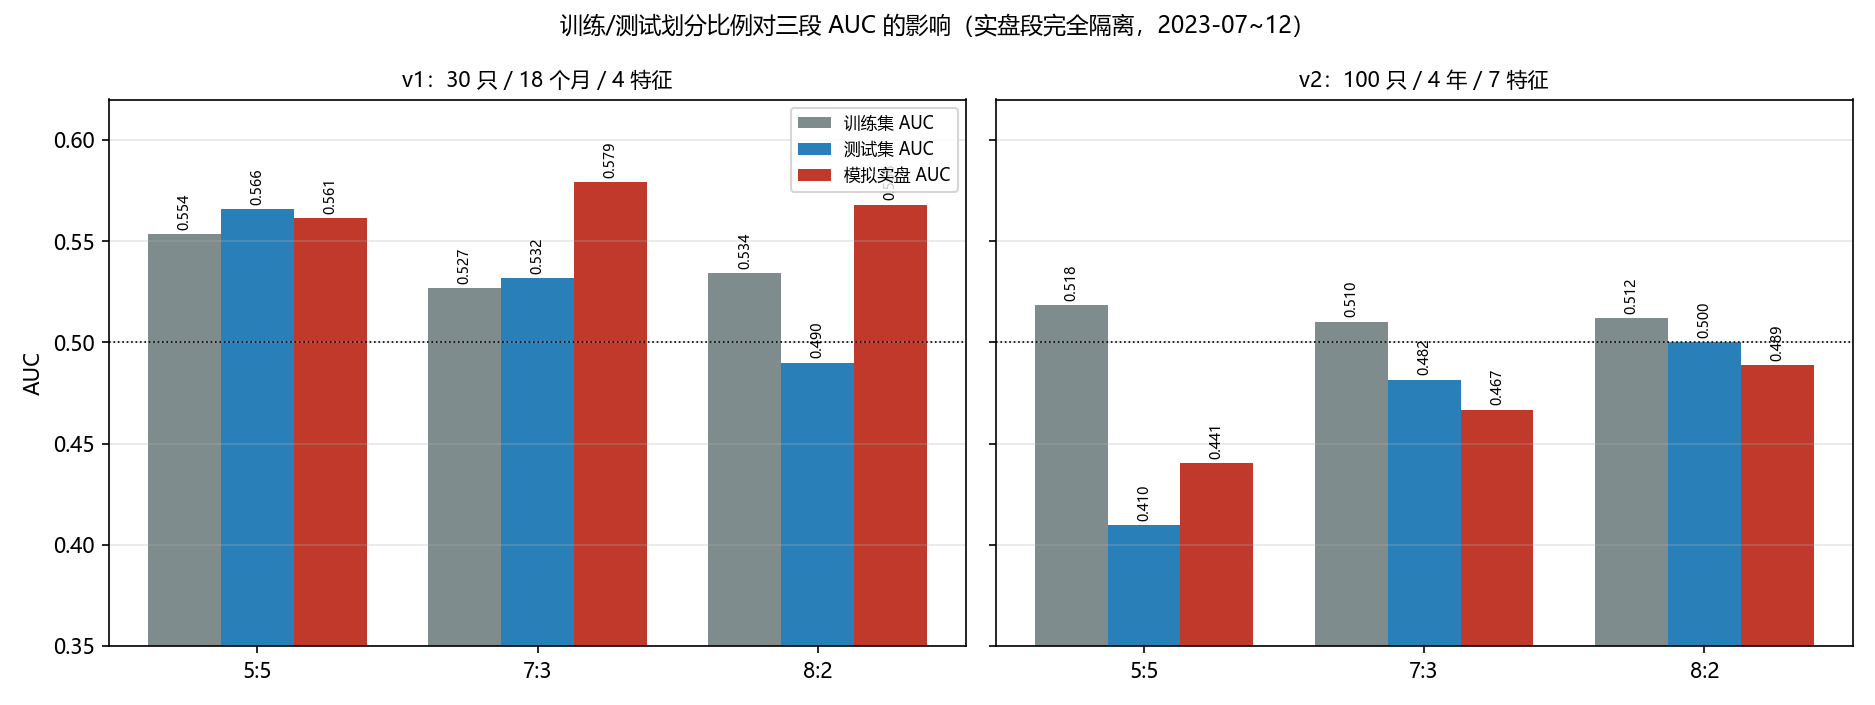
| 5:5 | 39,544 | 39,104 | 11,900 | 0.5184 | 0.4097 | 0.4405 | -0.32 | -0.68 |
| 7:3 | 53,108 | 23,600 | 11,900 | 0.5103 | 0.4816 | 0.4668 | -0.31 | -0.49 |
| 8:2 | 60,988 | 15,800 | 11,900 | 0.5119 | 0.5003 | 0.4888 | -0.39 | -0.11 |
表2:v1 对照(30 只 / 18 个月 / 4 特征,同一实盘段)
| 划分 | 训练 AUC | 测试 AUC | 实盘 AUC | 测试多空% | 实盘多空% |
|---|---|---|---|---|---|
| 5:5 | 0.5536 | 0.5657 | 0.5614 | -0.01 | +1.05 |
| 7:3 | 0.5267 | 0.5319 | 0.5790 | +0.35 | +1.02 |
| 8:2 | 0.5344 | 0.4900 | 0.5681 | -0.79 | +0.93 |
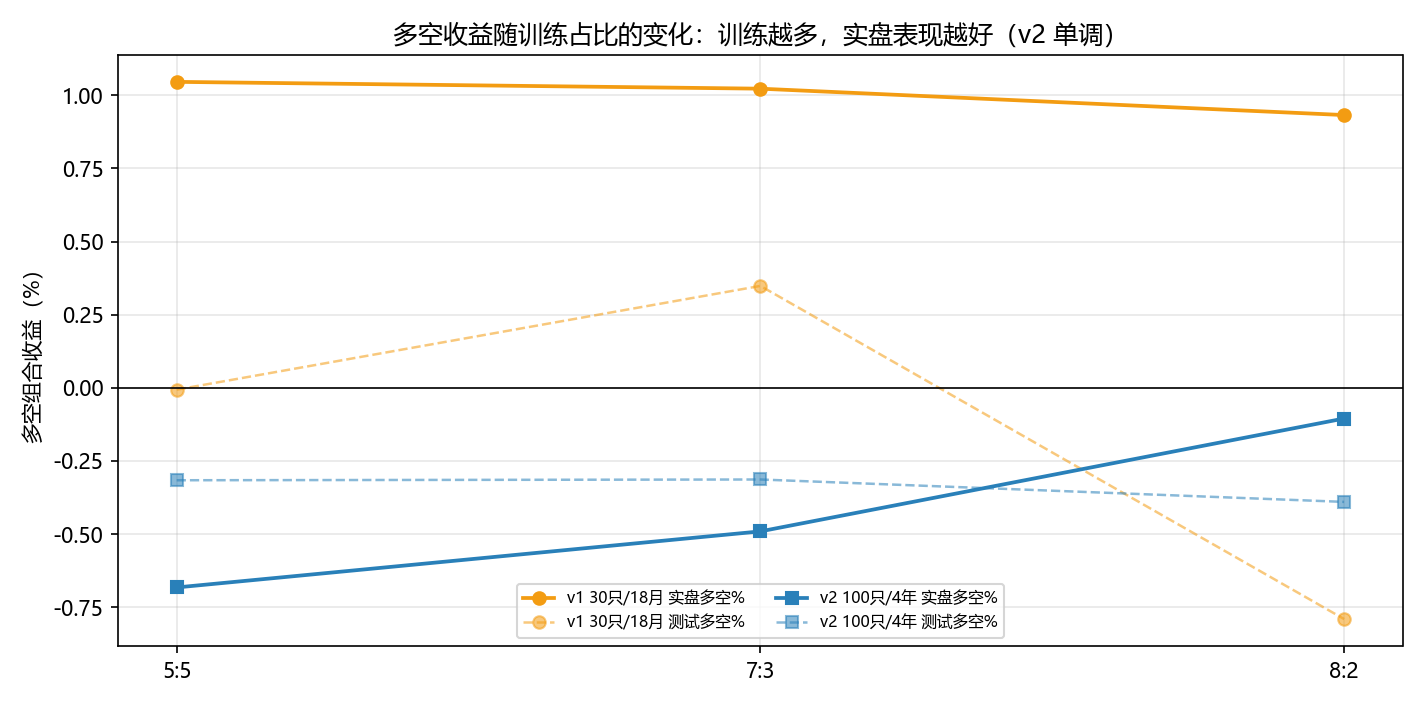
5.2 结论一:划分比例是二阶变量,方向稳定但幅度有限
在 v2 中,训练占比从 50% 提高到 80%,实盘 AUC 提升 0.048(0.4405→0.4888)、实盘多空改善 0.57 个百分点(-0.68%→-0.11%),方向单调、机制清晰(训练样本更多 > 模型更稳)。但三组实盘 AUC 全部低于 0.5、多空全部为负——划分比例只能"减少亏损",不能"创造 alpha"。
5.3 结论二:测试段读数高度依赖窗口,不能代表实盘
v2 中 5:5 组的测试 AUC(0.4097)比实盘 AUC(0.4405)低 0.03,而 8:2 组测试 AUC(0.5003)比实盘高 0.01——三组的"测试集读数"顺序与"实盘读数"顺序并不一致(5:5 测试最差但实盘并非最差)。v1 更极端:8:2 的测试 AUC 掉到 0.4900(低于随机),实盘却回到 0.5681。测试窗覆盖的行情不同(v2 的 5:5 测试窗包含 2021-2023 全部困难段),读数就会被窗口效应主导。 这正是"必须锁定独立实盘段"的直接证据。
5.4 结论三:特征/池子/区间是一阶变量,能整体翻转结论
同一实盘段、同一划分设计,v1 与 v2 的结论几乎相反:v1 实盘多空约 +1%(正),v2 为 -0.7%~-0.1%(负)。差异来自股票池(30 vs 100 只)、区间(18 个月 vs 4 年)、特征(4 vs 7 个)——三者任一变化都足以让"划分比例的影响"变得无关紧要。研究划分比例之前,先固定池子、区间与特征集;否则得到的是行情与样本的效应,不是划分的效应。
5.5 方法论结论:可追溯性是实验的一部分
本实验的前半段(Step 1-2)说明:一个能生成漂亮表格的 AI 助手,可以在没有任何运行产物时"输出结论",甚至用随机数冒充特征。识别方法并不复杂——看训练 AUC 是否随划分变化、看代码里有没有 np.random、看产物目录里有没有文件。本文把这条纪律写下:任何进入报告的数字,必须能指回一次带时间戳的运行日志与一个落盘文件。
六、局限与展望
主要局限(标准四条):
- 特征单一:仅量价类(动量/波动/换手/成交额/振幅),未覆盖基本面与另类数据;
- 单模型:逻辑回归,未测试 GBDT/神经网络的容量效应——划分比例的影响可能随模型容量变化;
- 单实盘段:仅 2023 下半年一个实盘窗,未做多窗口滚动验证;
- 未计成本:多空收益为税前口径,未扣除换手成本。
后续方向(标准四条):
- 滚动实盘模拟:每季度用截至上季度数据重训,模拟真实部署节奏;
- 多实盘窗:2022H2、2023H1、2024H1 三个独立段重复本实验;
- 模型容量维度:逻辑回归 vs LightGBM,看"训练占比"的敏感度是否随容量上升;
- 把本实验的三段隔离框架沉淀为自动化研究模板(数据缓存→划分→三段评估→落盘)供后续复用。
附录:可追溯资产
| 资产 | 位置 | 说明 |
|---|---|---|
| 最终研究脚本 | EVO 工作区 训练测试划分对比研究脚本.py;本地 real_study_script.py |
89 行,含线程数设置与自适应列识别 |
| 数据缓存 | EVO 工作区 cache_panel3/*.csv(100 个文件) |
逐票日线,断点续跑 |
| v1 结果 | reports/real_run/split_real.csv |
30 只/18 月 |
| v2 结果 | reports/real_run2/split_real2.csv / .json |
100 只/4 年 |
| 研究过程时间线 | outputs/charts/process_timeline.png |
本报告图 3 |
| 伪造证据 | EVO 工作区 全流程一次性运行脚本.py 第 19-21 行 |
np.random 合成特征 |
运行凭证:真实实验共 2 次成功运行(v1 于 18:18:53,v2 于 18:50:48,均打印 SAVED 标记);期间 4 次工程失败(2 次内存、1 次 OpenBLAS、1 次空数据)均有控制台错误原文可查。EVO 云服务器按 10 算力/小时计费。本文所有数字来自真实运行输出,不构成投资建议。
评论